Нейросети всё чаще отвечают на вопрос сами, а сайты показывают в виде источников под ответом. Чтобы попасть в эти источники, нужно как минимум одно: робот нейросети должен иметь возможность прочитать сайт. Звучит очевидно, но на практике сайты нередко закрывают таких роботов — шаблонным robots.txt, правилом от хостинга или «на всякий случай».
Разберём, каких роботов стоит пускать, зачем нужен llms.txt и как проверить всё это за минуту — вручную или в бесплатной проверке готовности к ИИ-поиску без регистрации.
Какие роботы ходят на сайт за нейросетями
У каждого AI-сервиса свой робот со своим именем (User-agent). Основные:
| Робот | Чей | Для чего |
|---|---|---|
| YandexAdditional | Яндекс | Ответы Нейро и другие генеративные функции Яндекса |
| GPTBot | OpenAI | Сбор данных для моделей |
| OAI-SearchBot | OpenAI | Поиск в ChatGPT — источники под ответом |
| ChatGPT-User | OpenAI | Когда пользователь просит ChatGPT открыть страницу |
| ClaudeBot | Anthropic | Сбор данных для моделей Claude |
| PerplexityBot | Perplexity | Поисковый индекс Perplexity |
| Google-Extended | Использование контента в Gemini |
Важная деталь: правила для обычного Googlebot или Yandex не всегда распространяются на этих роботов. Если в robots.txt есть блок User-agent: * с Disallow: /, а для поисковых роботов сделаны отдельные разрешения, AI-роботы попадут под общий запрет.
Как случайно закрыть сайт от нейросетей
Частые сценарии:
- шаблонный robots.txt от конструктора или темы, где все неизвестные роботы закрыты;
- правило от хостинга или CDN, которое блокирует «ботов» целиком;
- решение «закрыть от ИИ», принятое когда-то из опасений за контент — и забытое;
- запрет только для части роботов: например, GPTBot закрыт, а OAI-SearchBot нет — и наоборот.
Закрывать AI-роботов — законное решение, если вы не хотите, чтобы контент использовался для обучения. Но тогда стоит понимать цену: сайт не будет попадать в источники ответов этих сервисов. Для бизнеса, которому нужны клиенты из поиска, это обычно потеря.
Подробнее о синтаксисе файла — в словаре: robots.txt.
Как проверить вручную
- Откройте
ваш-сайт.ру/robots.txt. - Найдите блоки
User-agentс именами из таблицы выше и общий блокUser-agent: *. - Проверьте, нет ли в них
Disallow: /или запрета на важные разделы.
Если файл длинный, с десятками правил и исключениями, глазами легко ошибиться: порядок и специфичность правил влияют на результат.
Бесплатная проверка одной страницы
Чтобы не разбирать robots.txt вручную, впишите адрес в проверку готовности к ИИ-поиску. Она открывает страницу так, как это делает робот, — без выполнения JavaScript — и проходит шесть разделов:
| Раздел | Что смотрим |
|---|---|
| Доступ для роботов нейросетей | Семь роботов из таблицы выше и обычные YandexBot и Googlebot: открыт ли адрес и какое правило решило — из своей группы робота или из общей User-agent: * |
| Текст без JavaScript | Сколько слов видно в исходном HTML и нет ли признаков сборки в браузере: пустого контейнера приложения или заглушки «включите JavaScript» |
| Структура для цитирования | Один H1, подзаголовки H2 и H3 по порядку, первый абзац как прямой ответ (ориентир — 40–80 слов), списки, таблицы и блок вопросов |
| Разметка, автор и даты | Organization, Article, Person, Product, BreadcrumbList, автор, datePublished и dateModified, видимая дата обновления |
| Метатеги и индексация | title, description, canonical, Open Graph, noindex в метатеге и в заголовке X-Robots-Tag, запрет фрагментов nosnippet |
| Файл llms.txt | Есть ли файл, текст ли это, а не HTML-страница, и сколько в нём ссылок |
Роботов проверка делит на две группы. Тех, кто собирает данные для обучения (GPTBot, ClaudeBot, Google-Extended), закрыть — законный выбор, и это не считается ошибкой. А закрытый робот, который ищет ответы для пользователей (YandexAdditional, OAI-SearchBot, ChatGPT-User, PerplexityBot), попадает в начало списка: такой сервис не сможет сослаться на страницу.
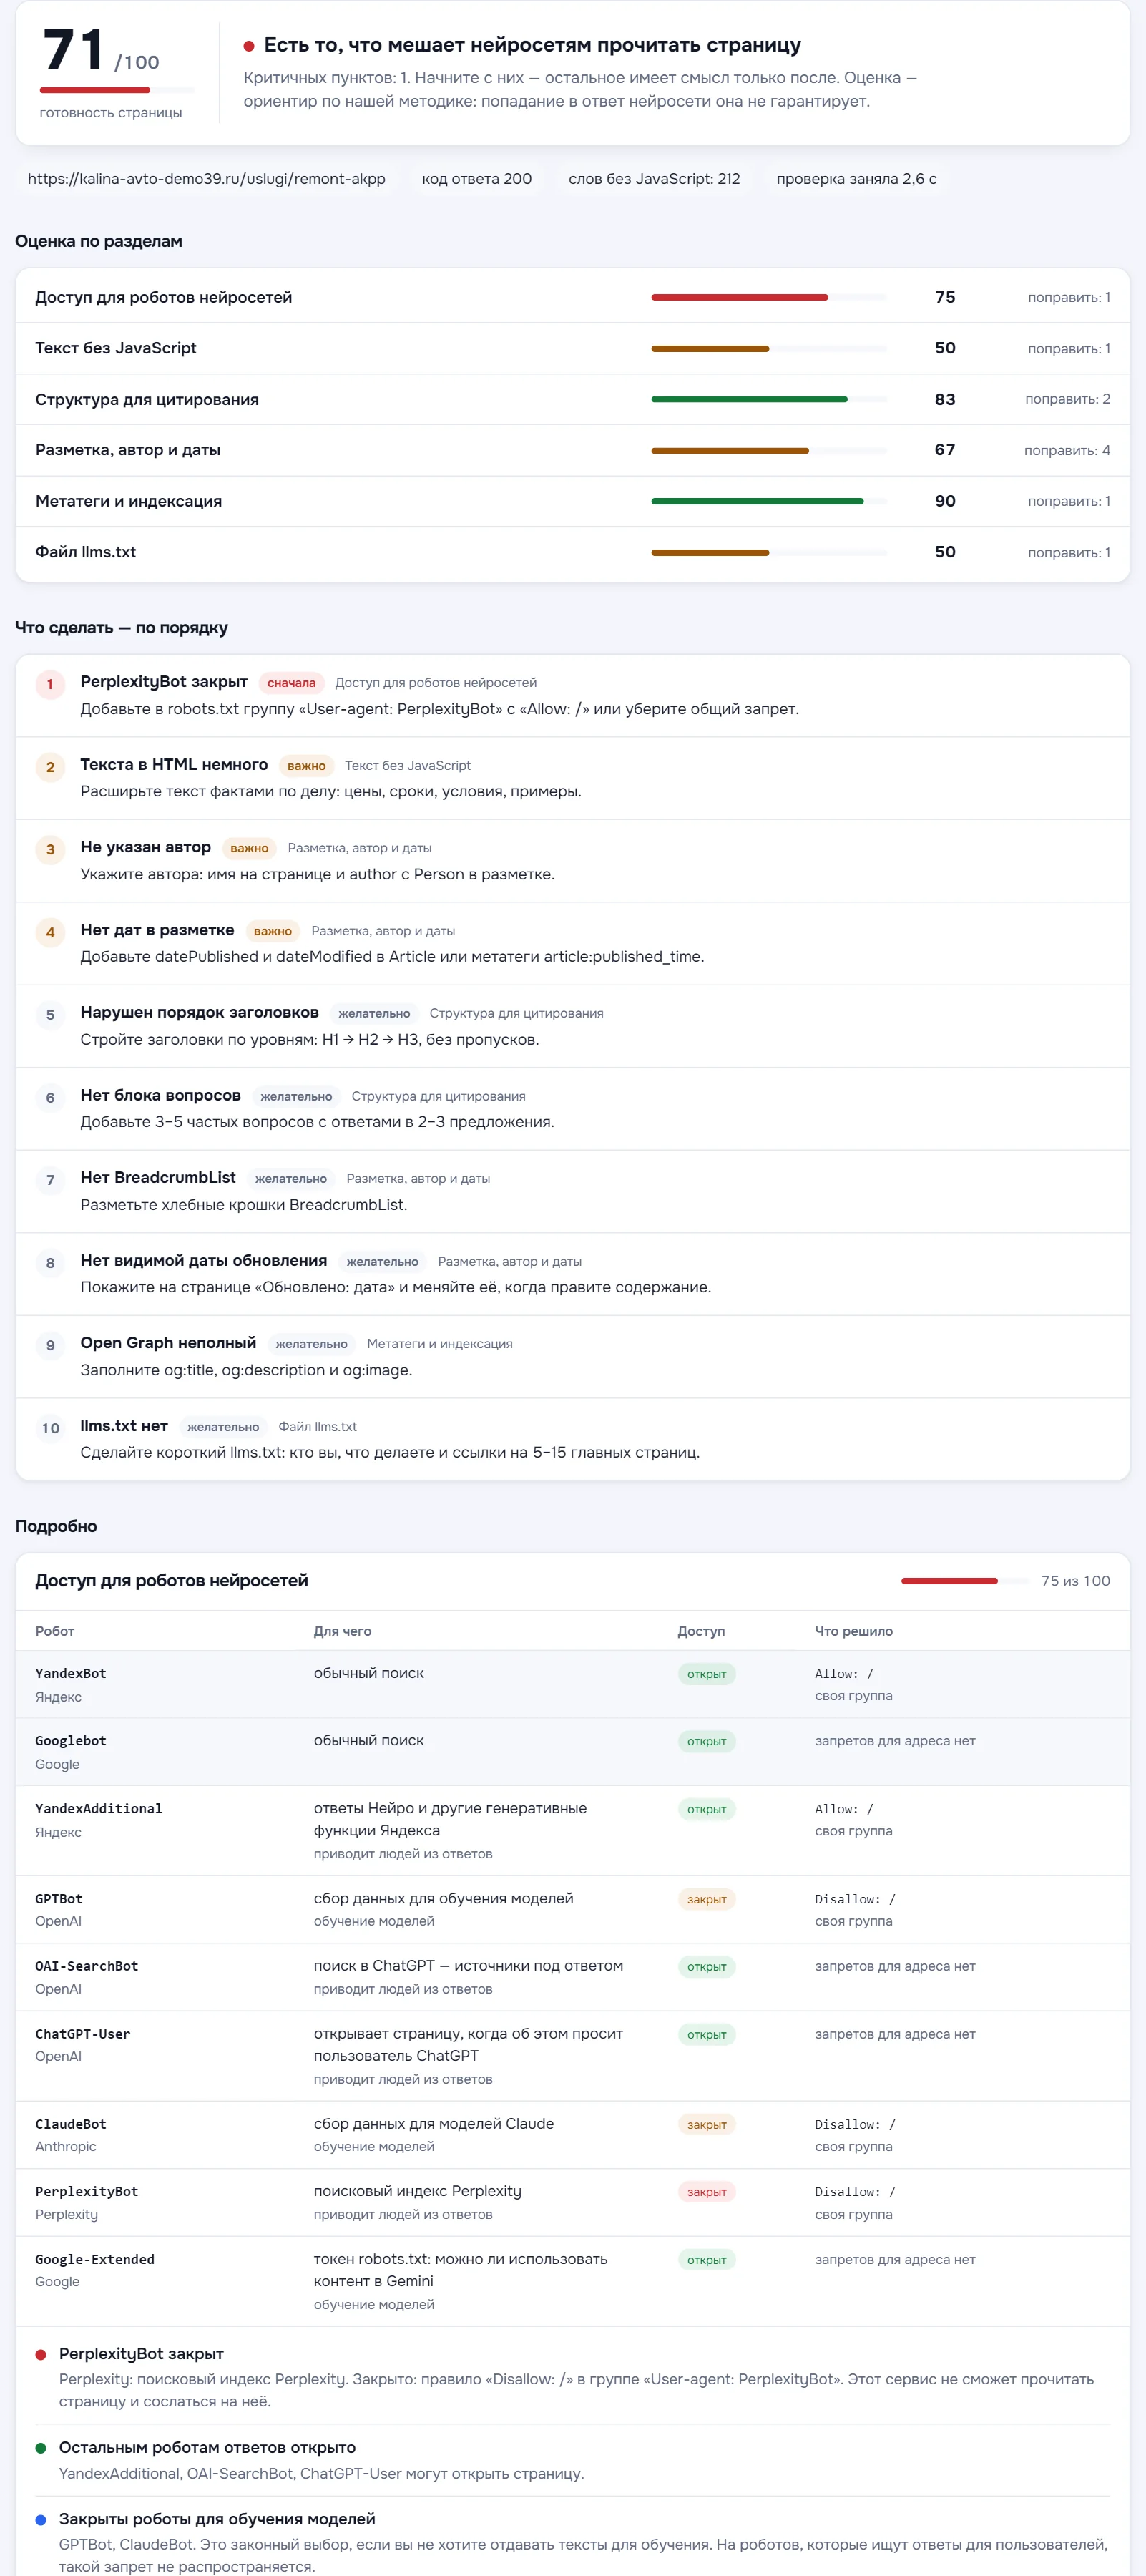
Итог — оценка по разделам и список «что сделать» по приоритету: сначала то, что мешает прочитать страницу, потом важное, потом желательное. Оценка — ориентир по нашей методике, а не обещание: кого взять в ответ, решает сама нейросеть.
Что такое llms.txt и нужен ли он
llms.txt — текстовый файл в корне сайта с кратким описанием: кто вы, чем занимаетесь, какие страницы главные. Идея в том, чтобы дать нейросетям «шпаргалку» вместо того, чтобы разбирать сайт целиком.
Честно о статусе:
- это предложенный формат, а не стандарт; ни Яндекс, ни Google не заявляли, что используют его в ранжировании;
- он не заменяет нормальные HTML-страницы: цены, адреса, услуги должны быть в тексте сайта;
- файл дешёвый — сделать его можно за полчаса, вреда от него нет.
Поэтому в аудите отсутствие llms.txt — это замечание, а не ошибка. Пример минимального файла:
# Автосервис «Пример»
> Ремонт АКПП и вариаторов в Калининграде с 2012 года.

## Главное
- [Ремонт АКПП](https://example.ru/remont-akpp): цены и сроки
- [Контакты](https://example.ru/contacts): адрес, телефон, часы работы
Как следить за всем сайтом
Бесплатная проверка смотрит одну страницу. В аудите сайта есть раздел «Готовность к AI-поиску». Он делает две проверки:
- роботы нейросетей могут читать сайт — аудит разбирает robots.txt и проверяет доступ для каждого из семи роботов из таблицы. Если кто-то закрыт, они перечислены поимённо — сразу видно, что именно поправить;
- есть llms.txt — проверяется, что файл отдаётся по адресу
/llms.txtи это текст, а не HTML-страница ошибки.
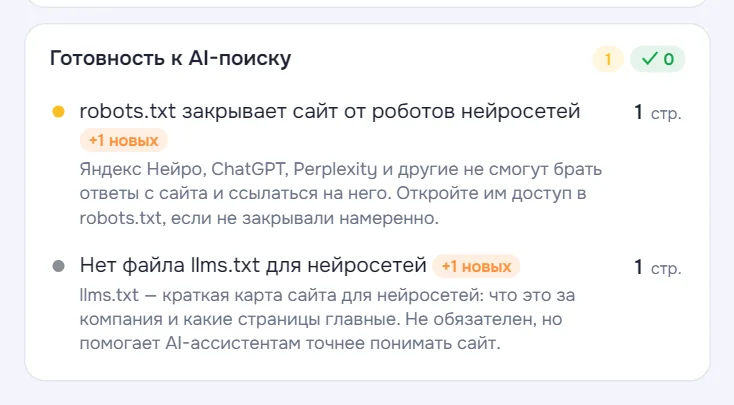
Проверки появились в новой версии аудита. Старые отчёты не делают вид, что эти пункты пройдены: результат появится при следующем запуске.
Что делать после проверки
- Если роботы закрыты случайно — добавьте в robots.txt разрешающие блоки, например:
User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /- Если закрыты намеренно — решите, каких роботов пускать. Компромисс, который часто выбирают: закрыть роботов, собирающих данные для обучения, но пустить поисковых (OAI-SearchBot, PerplexityBot, YandexAdditional) — они приводят посетителей.
- Сделайте llms.txt с главными страницами — это 10–20 строк.
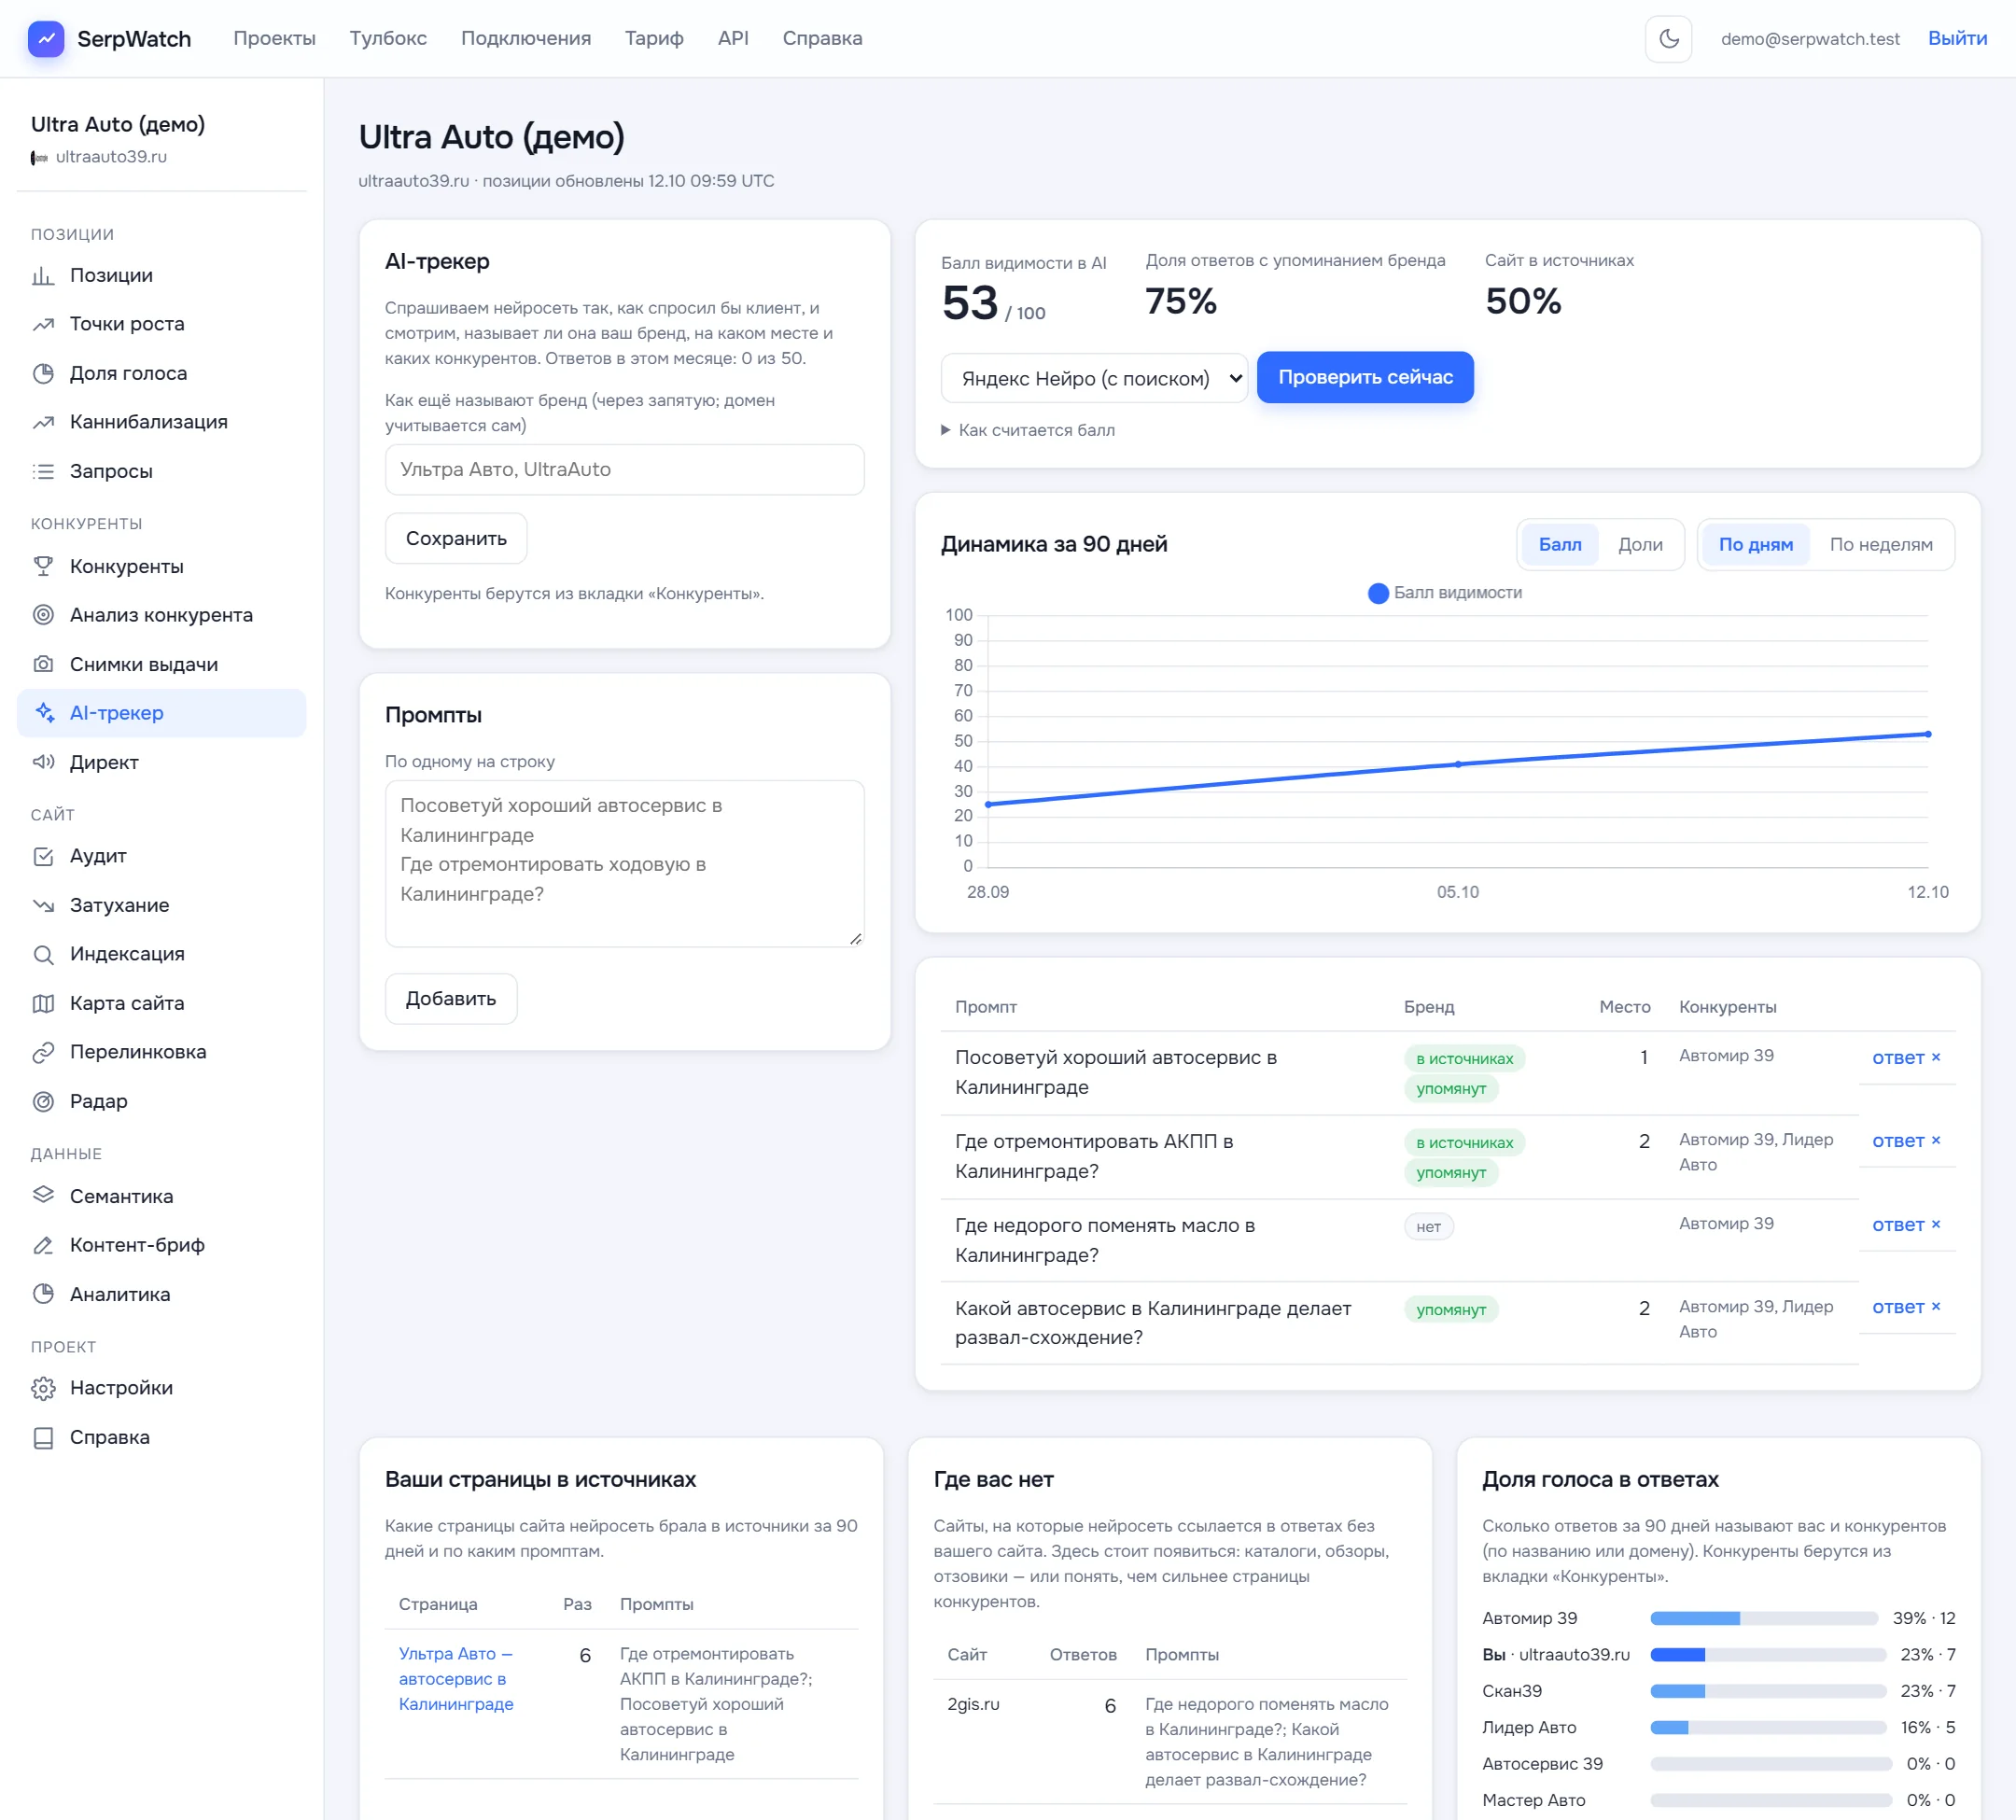
- Проверьте результат: прогоните страницу через бесплатную проверку или запустите аудит повторно и посмотрите, попадает ли сайт в ответы, через AI-трекер.
Доступ для роботов — только первый шаг. Дальше решают содержание страниц и упоминания на других площадках. Но без этого шага всё остальное не сработает: нейросеть не может сослаться на страницу, которую ей не дали прочитать.
Частые вопросы
Повлияет ли открытие AI-роботов на позиции в Яндексе и Google?
Нет. Доступ для роботов нейросетей не меняет ранжирование в обычном поиске. Он влияет только на то, могут ли AI-сервисы читать сайт и ссылаться на него.
Чем бесплатная проверка отличается от аудита?
Бесплатная проверка разбирает одну страницу подробно: роботов, текст без JavaScript, структуру, разметку и метатеги. Аудит обходит весь сайт и следит за доступом для роботов и llms.txt при каждом запуске.
Как часто проверять robots.txt?
После каждого переезда, смены CMS или хостинга и раз в месяц для живого сайта. Еженедельный мониторинг аудита покажет новые проблемы сам.
AI-трекер в SerpWatch
Упоминают ли ваш бренд нейросети и на какие сайты они ссылаются