robots.txt — небольшой текстовый файл в корне сайта, который говорит поисковым роботам, какие разделы обходить можно, а какие нельзя. Он читается раньше всего остального, поэтому одна неудачная строка способна закрыть от поиска весь каталог или, наоборот, открыть служебные страницы с фильтрами и корзиной.
Разберём, как устроен файл, какие ошибки встречаются чаще всего и как проверить robots.txt за минуту — бесплатно и без регистрации.
Как устроен robots.txt
Файл состоит из групп. Каждая группа начинается со строки User-agent — имени робота, — за которой идут правила Allow (можно) и Disallow (нельзя):
User-agent: *
Disallow: /admin/
Disallow: /*?sort=
Allow: /admin/help$

User-agent: Yandex
Disallow: /search/

Sitemap: https://site.ru/sitemap.xml
Несколько правил, которые важно помнить:
- Робот выбирает одну группу. Если есть группа с его именем, он следует только ей, а общую группу
*не читает. Частая ошибка — завести отдельную группу для Яндекса и забыть повторить в ней общие запреты. - Побеждает самое длинное правило. Для адреса
/admin/helpподходят иDisallow: /admin/, иAllow: /admin/help$— второе длиннее, поэтому страница открыта. При равной длине побеждаетAllow. - Звёздочка и доллар.
*заменяет любые символы,$означает конец адреса.Disallow: /*?sort=закрывает все адреса с сортировкой, аAllow: /page$открывает только сам/page, но не/page/2. - Sitemap — полным адресом. Директива указывается с
https://и доменом, а не относительным путём.
Частые ошибки
Сайт закрыт целиком. Строка Disallow: / в общей группе, оставшаяся после разработки, — классика. Сайт перестаёт обходиться, и страницы постепенно выпадают из поиска.
Опечатка в директиве. Dissalow, User agent без дефиса, пропущенное двоеточие — такие строки поисковики молча пропускают. Правило вроде бы написано, но не работает.
Правила до User-agent. Если Disallow стоит выше первой строки User-agent, непонятно, к какому роботу он относится, и правило игнорируется.
Своя группа без общих запретов. Для Яндекса завели группу с одним правилом — и он перестал видеть все остальные запреты из *.
Устаревшие директивы. Host Яндекс больше не учитывает: главное зеркало задают 301-редиректом. Crawl-delay не учитывают ни Яндекс, ни Google — скорость обхода настраивается в их кабинетах для вебмастеров.
Закрыты роботы нейросетей. Если в файле запрещён обход для роботов, которые собирают ответы для Яндекс Нейро, ChatGPT или Perplexity, сайт реже попадает в ответы нейросетей и ссылки на источники. Иногда это решение сознательное, но чаще — скопированный из чужого файла блок.
Disallow вместо noindex. Запрет обхода не убирает страницу из поиска: она может остаться в выдаче без описания, если на неё есть ссылки. Чтобы страница исчезла из поиска, нужен метатег noindex, а сама страница должна быть открыта для обхода, иначе робот этот метатег не увидит.
Как проверить robots.txt бесплатно
Откройте проверку robots.txt, впишите домен или адрес страницы и, если нужно, путь, доступ к которому хотите проверить. Через несколько секунд увидите:
- код ответа файла и редиректы, если он открывается не напрямую;
- группы правил — для какого робота что действует;
- директивы Sitemap;
- строки с ошибками синтаксиса и пояснение, что с каждой не так;
- таблицу доступа: можно ли обходить адрес роботу Яндекса, Googlebot и роботам нейросетей — и какое именно правило это решило.
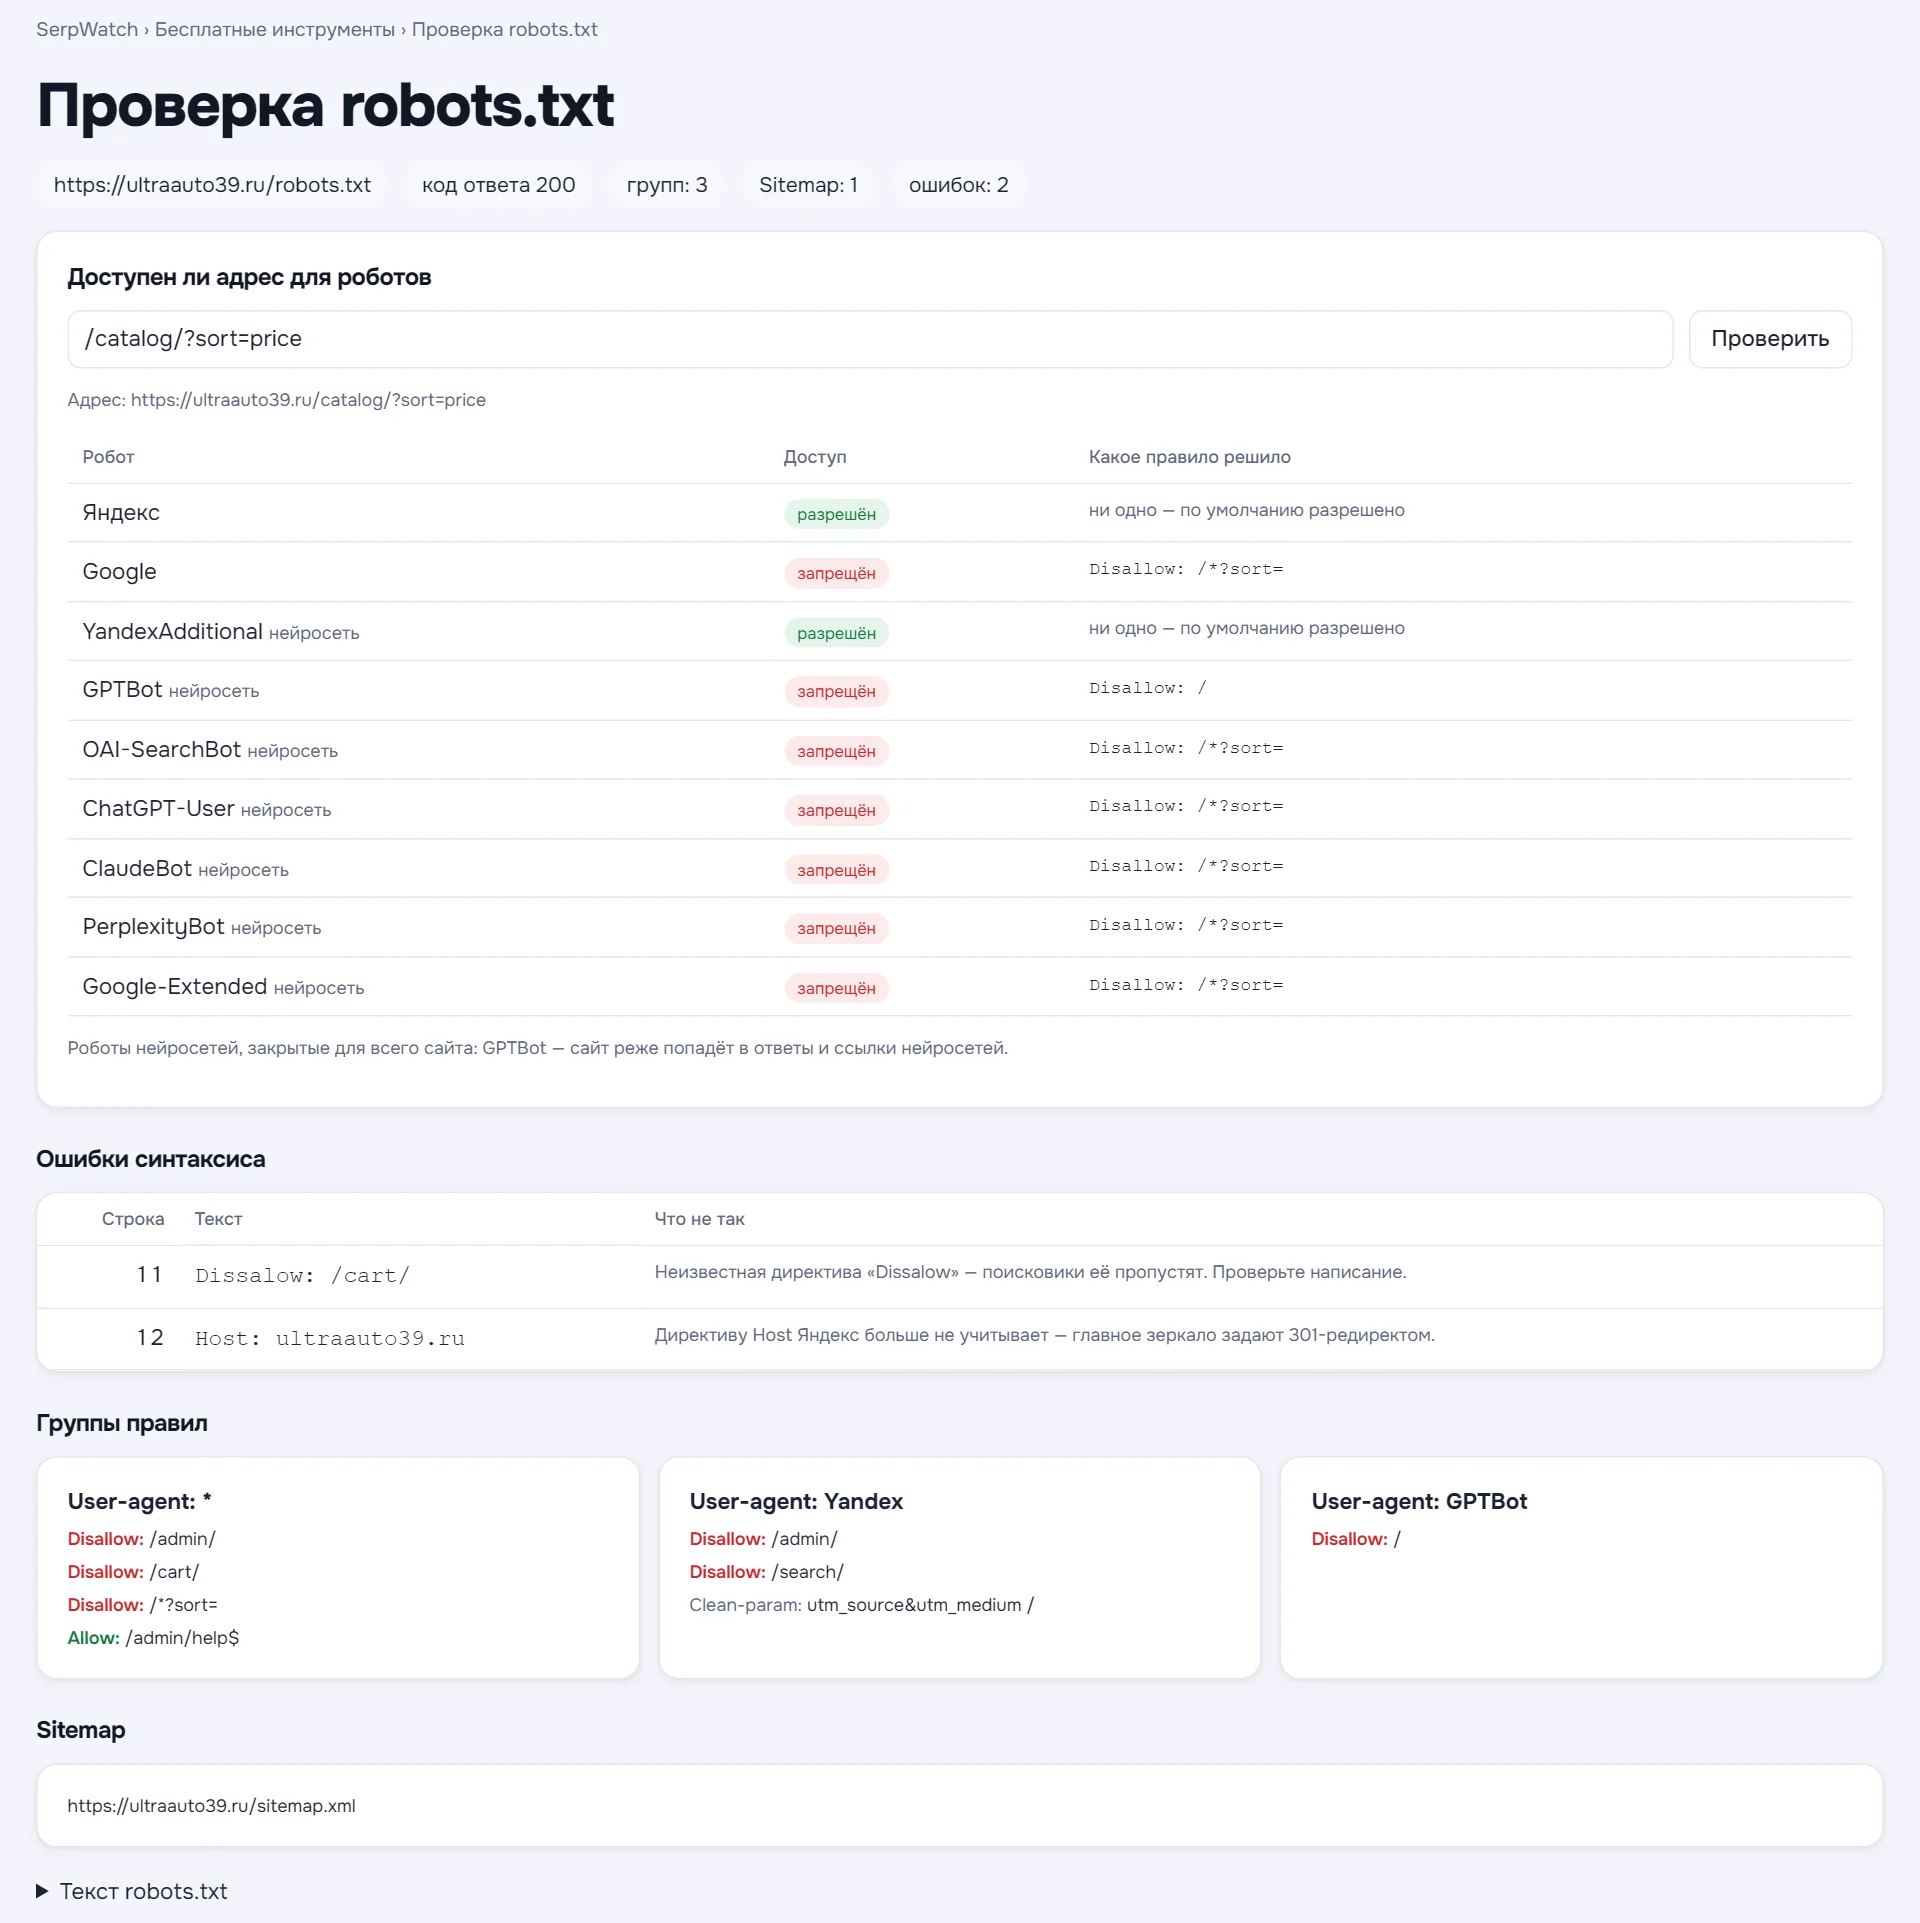
Другой адрес можно проверить прямо на странице результата — по уже загруженному файлу, без повторной проверки. Сопоставление идёт так же, как у поисковиков: самое длинное подходящее правило, звёздочка и доллар.
Что делать с результатом
- Проверьте главную и ключевые разделы. Если хоть один поисковик видит «запрещён» на важной странице — найдите решившее правило в таблице и исправьте его.
- Исправьте строки с ошибками. Опечатку в директиве поисковик просто пропустит, поэтому такие правила сейчас не действуют.
- Проверьте отдельные группы. Если есть группа для Яндекса или Google, повторите в ней все нужные общие запреты.
- Добавьте Sitemap полным адресом, если его нет.
- Решите насчёт нейросетей осознанно: если хотите попадать в их ответы, откройте обход для их роботов.
Следить, а не проверять вручную
robots.txt часто ломают незаметно: при обновлении CMS, переезде или выкладке тестовой версии. Разовая проверка покажет состояние сейчас, но не предупредит, когда файл изменится. В SerpWatch аудит сайта проверяет robots.txt при каждом обходе, находит закрытые от поиска страницы и роботов нейросетей, а мониторинг сайта сообщит, если файл поменялся. Зарегистрируйтесь — бесплатный тариф не ограничен по времени.
Частые вопросы
Где должен лежать robots.txt?
Строго в корне сайта: https://site.ru/robots.txt. Для поддомена нужен свой файл — правила основного домена на него не распространяются.
Как быстро поисковики учтут изменения?
Роботы перечитывают robots.txt регулярно, обычно в течение суток. Но чтобы закрытые раньше страницы вернулись в поиск, их ещё нужно заново обойти — это может занять от нескольких дней до пары недель.
Нужно ли закрывать от роботов страницы фильтров и сортировки?
Обычно да: такие адреса создают тысячи похожих страниц и тратят ресурсы робота. Закрыть их можно правилом вроде Disallow: /*?sort=, а для Яндекса — ещё и директивой Clean-param, которая склеивает адреса с лишними параметрами.
Аудит сайта в SerpWatch
≈45 проверок по 8 разделам, Core Web Vitals, подсказки как исправить, экспорт в Excel