Вебмастер и Search Console рассказывают, что поисковик думает о сайте. Лог сервера показывает, что робот на сайте на самом деле делал: на какие адреса заходил, в какой день, какой ответ получил. Это самый честный источник данных об обходе — сервер записывает каждый запрос, ничего не выбирая и не округляя.
Ниже — что можно найти в логах, какие роботы там встречаются, как понять, что обход тратится впустую, и где взять сам файл.
Что показывают логи и чего нет в панелях поисковиков
Лог доступа (access log) — текстовый файл, где на каждый запрос к сайту приходится одна строка: IP-адрес, время, адрес страницы, код ответа и User-Agent — подпись программы, которая пришла. По User-Agent отличают людей от роботов и роботов друг от друга.
Панели поисковиков дают выборку и сводки с задержкой в несколько дней. Лог даёт полную картину:
- сколько раз робот заходил на каждую страницу — а не только «страница в поиске» или «исключена»;
- какие адреса робот видит, хотя вы о них забыли: старые разделы, страницы с метками, служебные скрипты;
- какие ответы он получает именно в момент обхода — редиректы, 404 и 5xx, которых люди могли не заметить;
- роботов нейросетей — их нет ни в Вебмастере, ни в Search Console, а в логе они видны так же, как Googlebot.
Какие роботы встречаются в логах
Удобно делить роботов на две группы.
Поисковые роботы обходят сайт, чтобы страницы попадали в выдачу: YandexBot и другие роботы Яндекса (YandexImages для картинок, YandexMobileBot для мобильной версии), Googlebot, Bingbot, робот Mail.ru. Если важная страница неделями не получает заходов поискового робота, новые правки на ней поисковик просто не видит.
Роботы нейросетей собирают тексты для обучения моделей и для ответов в чатах:
- GPTBot, OAI-SearchBot и ChatGPT-User — OpenAI (обучение, поиск в ChatGPT, открытие страницы по просьбе человека);
- ClaudeBot, Claude-SearchBot и Claude-User — Anthropic;
- PerplexityBot и Perplexity-User — Perplexity;
- YandexAdditional — Яндекс, ответы Алисы и Нейро;
- Applebot, Bytespider, CCBot, meta-externalagent — Apple, ByteDance, открытый архив Common Crawl и Meta.
Подробнее о том, чем они отличаются и как ими управлять, — в статье словаря про ИИ-краулеры. Если вы хотите попадать в ответы нейросетей, проверьте, что эти роботы вообще доходят до сайта. Бывает, что их случайно закрыли в robots.txt или блокирует защита хостинга.
Учтите: User-Agent робот сообщает о себе сам, и подделать его может любой парсер. Если «Googlebot» ведёт себя странно — тысячи заходов в час, сплошные ошибки, — проверьте IP: настоящие роботы Google и Яндекса приходят с адресов этих компаний, это проверяется обратным DNS-запросом.
Краулинговый бюджет: куда уходит обход
Робот не обходит сайт целиком каждый день. У каждого сайта есть свой лимит — краулинговый бюджет: сколько страниц поисковик готов скачать за период. На небольшом сайте его обычно хватает. На интернет-магазине с фильтрами или на портале с тысячами статей бюджет легко уходит не туда.
По логу видно три главные утечки.
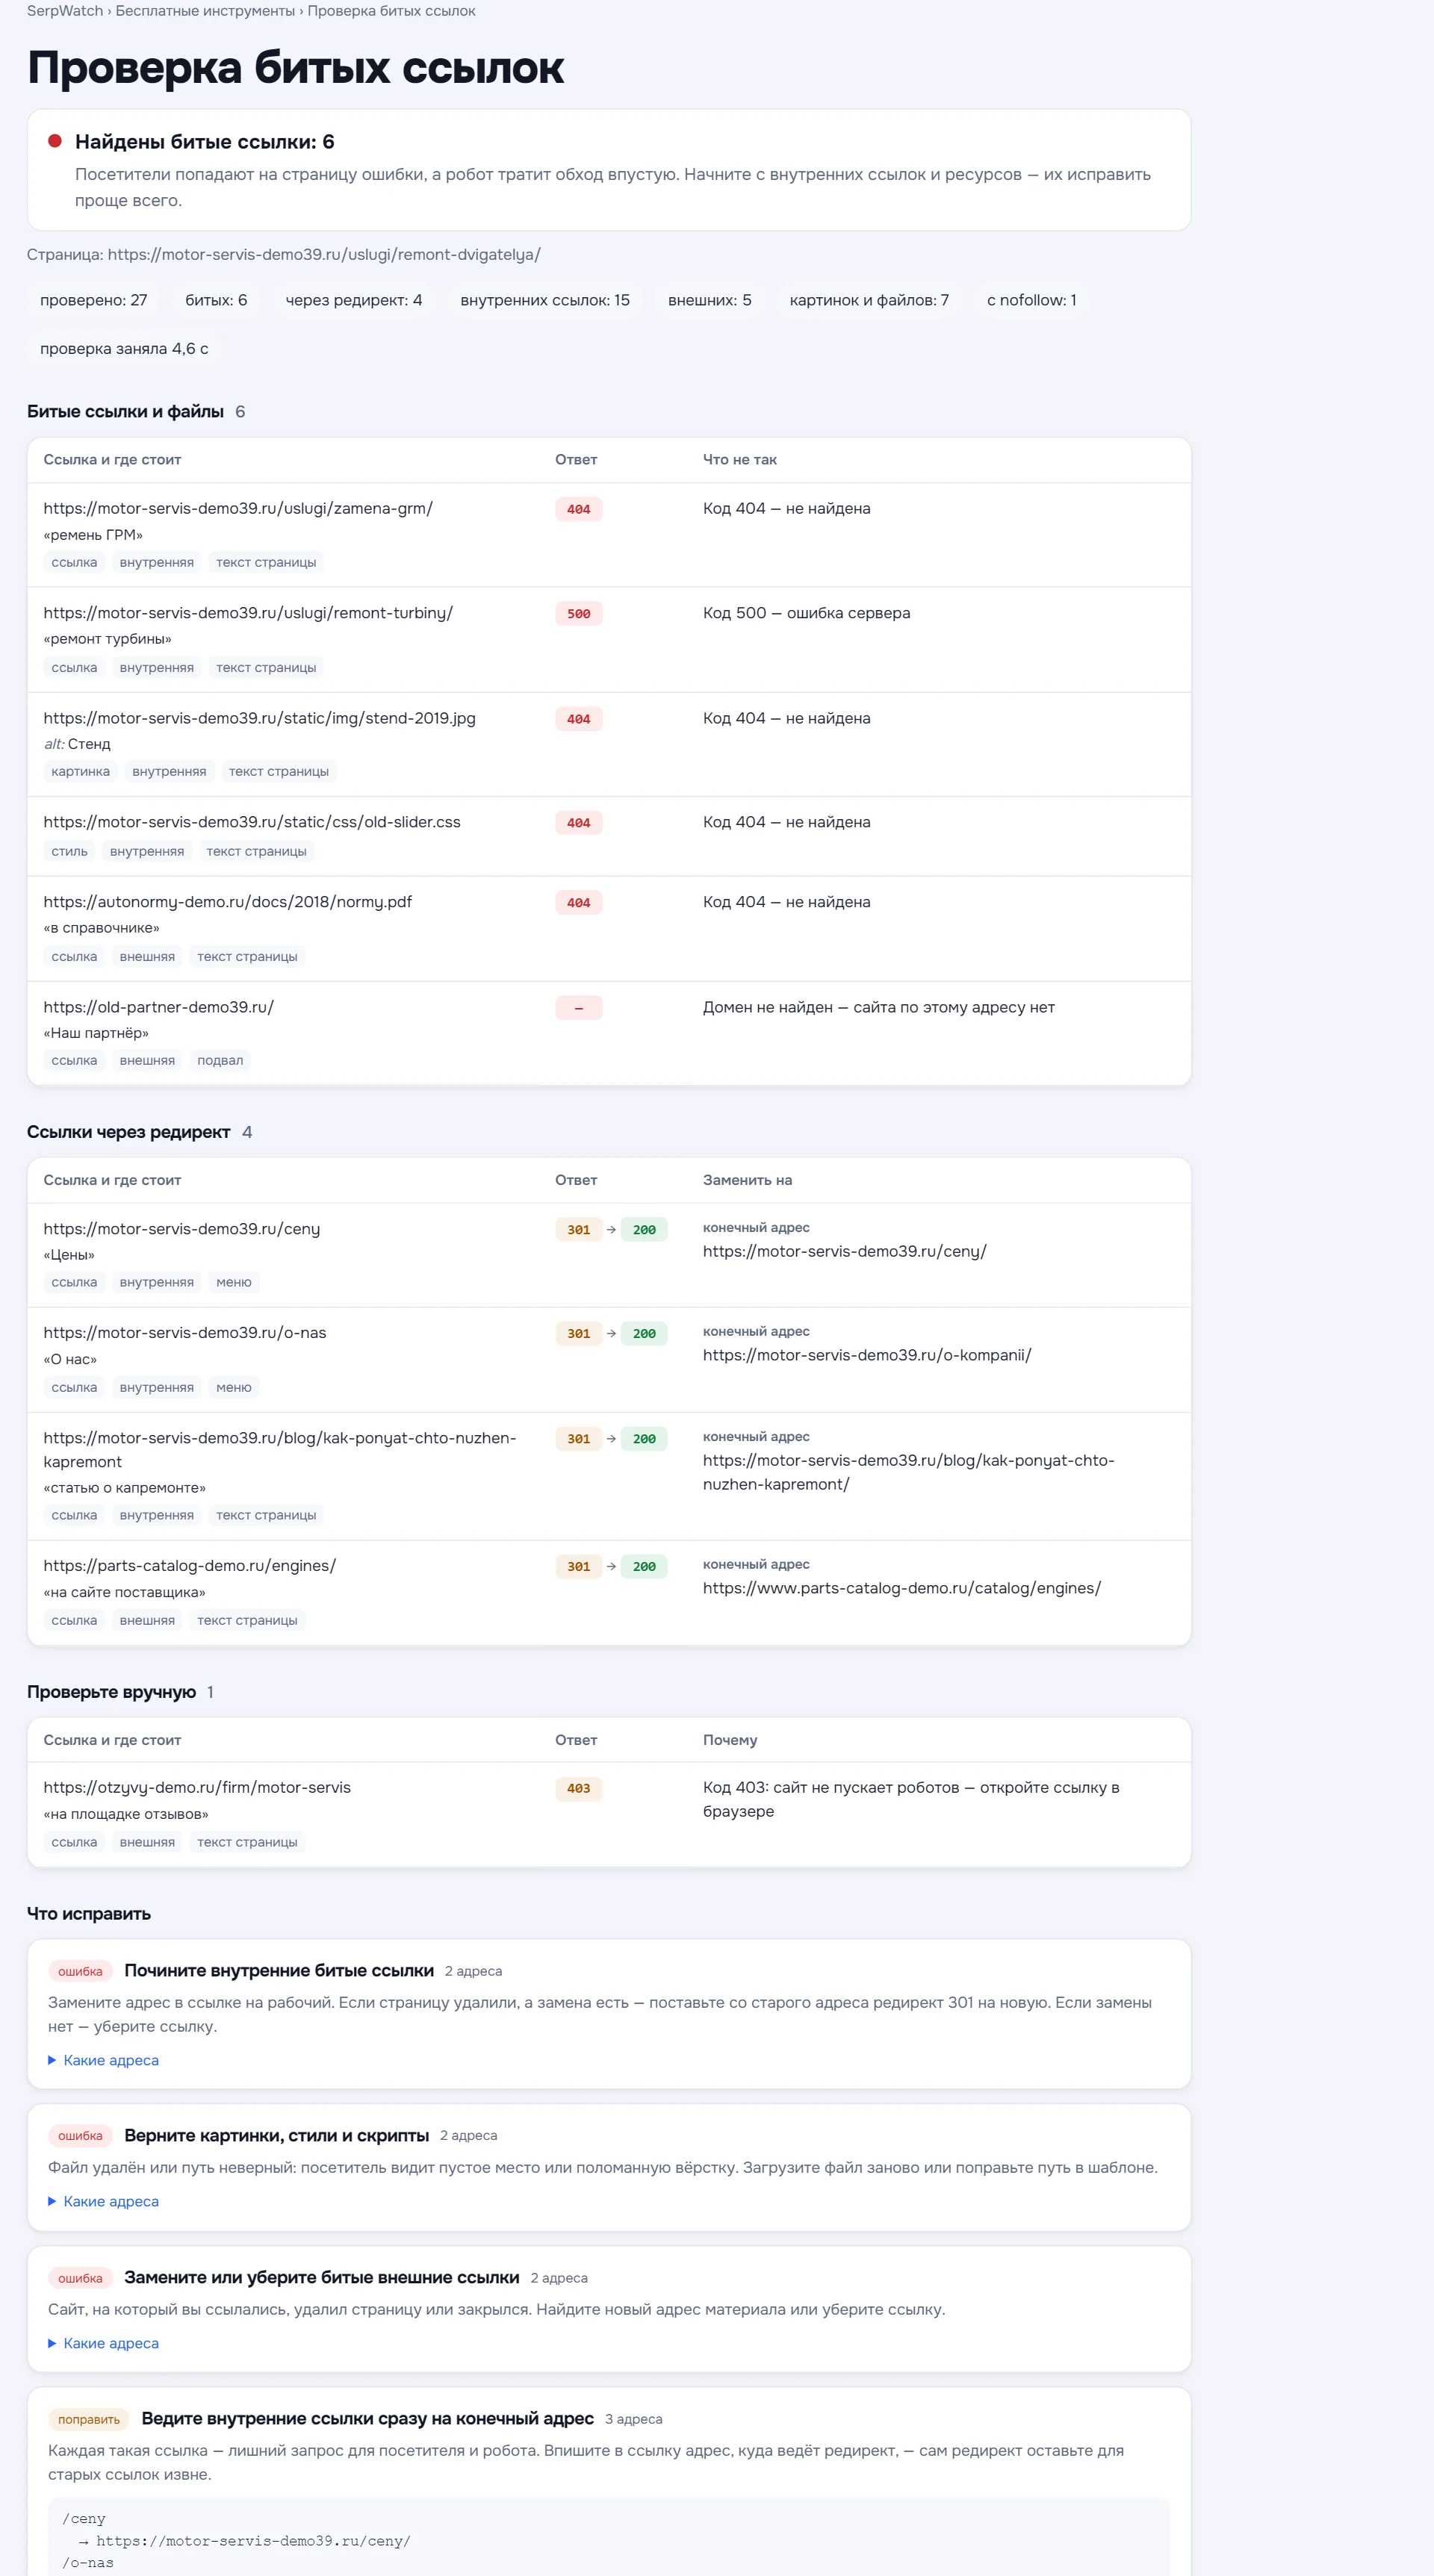
Редиректы. Каждый заход на адрес с 301 редиректом — лишний шаг. Если робот постоянно приходит на старые адреса, значит, на них всё ещё ведут ссылки с сайта или из карты сайта. Замените их на конечные адреса.
Ошибки 4xx и 5xx. Заходы на страницы 404 — это удалённые товары, опечатки в ссылках, старые разделы. Ошибки 5xx опаснее: если сервер часто не отвечает роботу, поисковик снижает частоту обхода, а страницы могут временно выпасть из поиска.
Адреса с параметрами. Метки ?utm_source=, сортировки ?sort=, фильтры и номера страниц плодят копии одной и той же страницы. Робот честно обходит каждую. Лечится это так: убрать такие ссылки из внутренних, закрыть лишние параметры директивой Clean-param для Яндекса и указать canonical на основную страницу.
Хороший ориентир: на редиректы, ошибки и адреса с параметрами должно уходить не больше 10–15 % заходов поисковых роботов. Если больше — пора чистить.
Страницы, куда роботы не заходят
Самый полезный отчёт получается, если сравнить лог со списком страниц сайта. Страницы, которые есть в карте сайта или находятся при обходе, но за месяц ни разу не получили захода поискового робота, — первые кандидаты на проблемы с индексацией.
Обычно причина одна из трёх:
- на страницу нет ссылок или она слишком глубоко — в пяти кликах от главной;
- страницы нет в sitemap.xml, и робот о ней не знает;
- страница закрыта в robots.txt или отдаёт ошибку роботу, хотя у человека в браузере открывается.
Решение почти всегда — ссылки из меню, разделов и похожих материалов, плюс проверка карты сайта.
Как получить лог
Лог пишет веб-сервер, а не CMS, поэтому искать его нужно на сервере или в панели хостинга.
- Свой сервер с nginx — файл
/var/log/nginx/access.log. Старые дни лежат рядом:access.log.1,access.log.2.gzи так далее. Скачайте их по SFTP. - Apache —
/var/log/apache2/access.logили/var/log/httpd/access_log. - Виртуальный хостинг — в панели управления есть раздел «Логи» или «Журналы»: выберите сайт и скачайте журнал доступа. На некоторых тарифах его нужно сначала включить.
- 1С-Битрикс, WordPress и другие CMS — путь тот же: лог берут у веб-сервера, через панель хостинга или у администратора.
Нужен стандартный формат combined — так пишут nginx и Apache по умолчанию. Лучше взять 2–4 недели: за один день картина случайна. Большие файлы удобно сжать в .gz — так их быстрее загружать.
Как это выглядит в SerpWatch
В проекте откройте раздел «Сайт» → «Анализ логов» и загрузите файл (до 50 МБ, обычный или .gz). Сервис разберёт его за несколько секунд и покажет: какие роботы заходят и сколько раз по дням, долю поисковых роботов и роботов нейросетей, последний заход каждого, коды ответа, адреса с редиректами и ошибками, обход адресов с параметрами и самые посещаемые страницы.
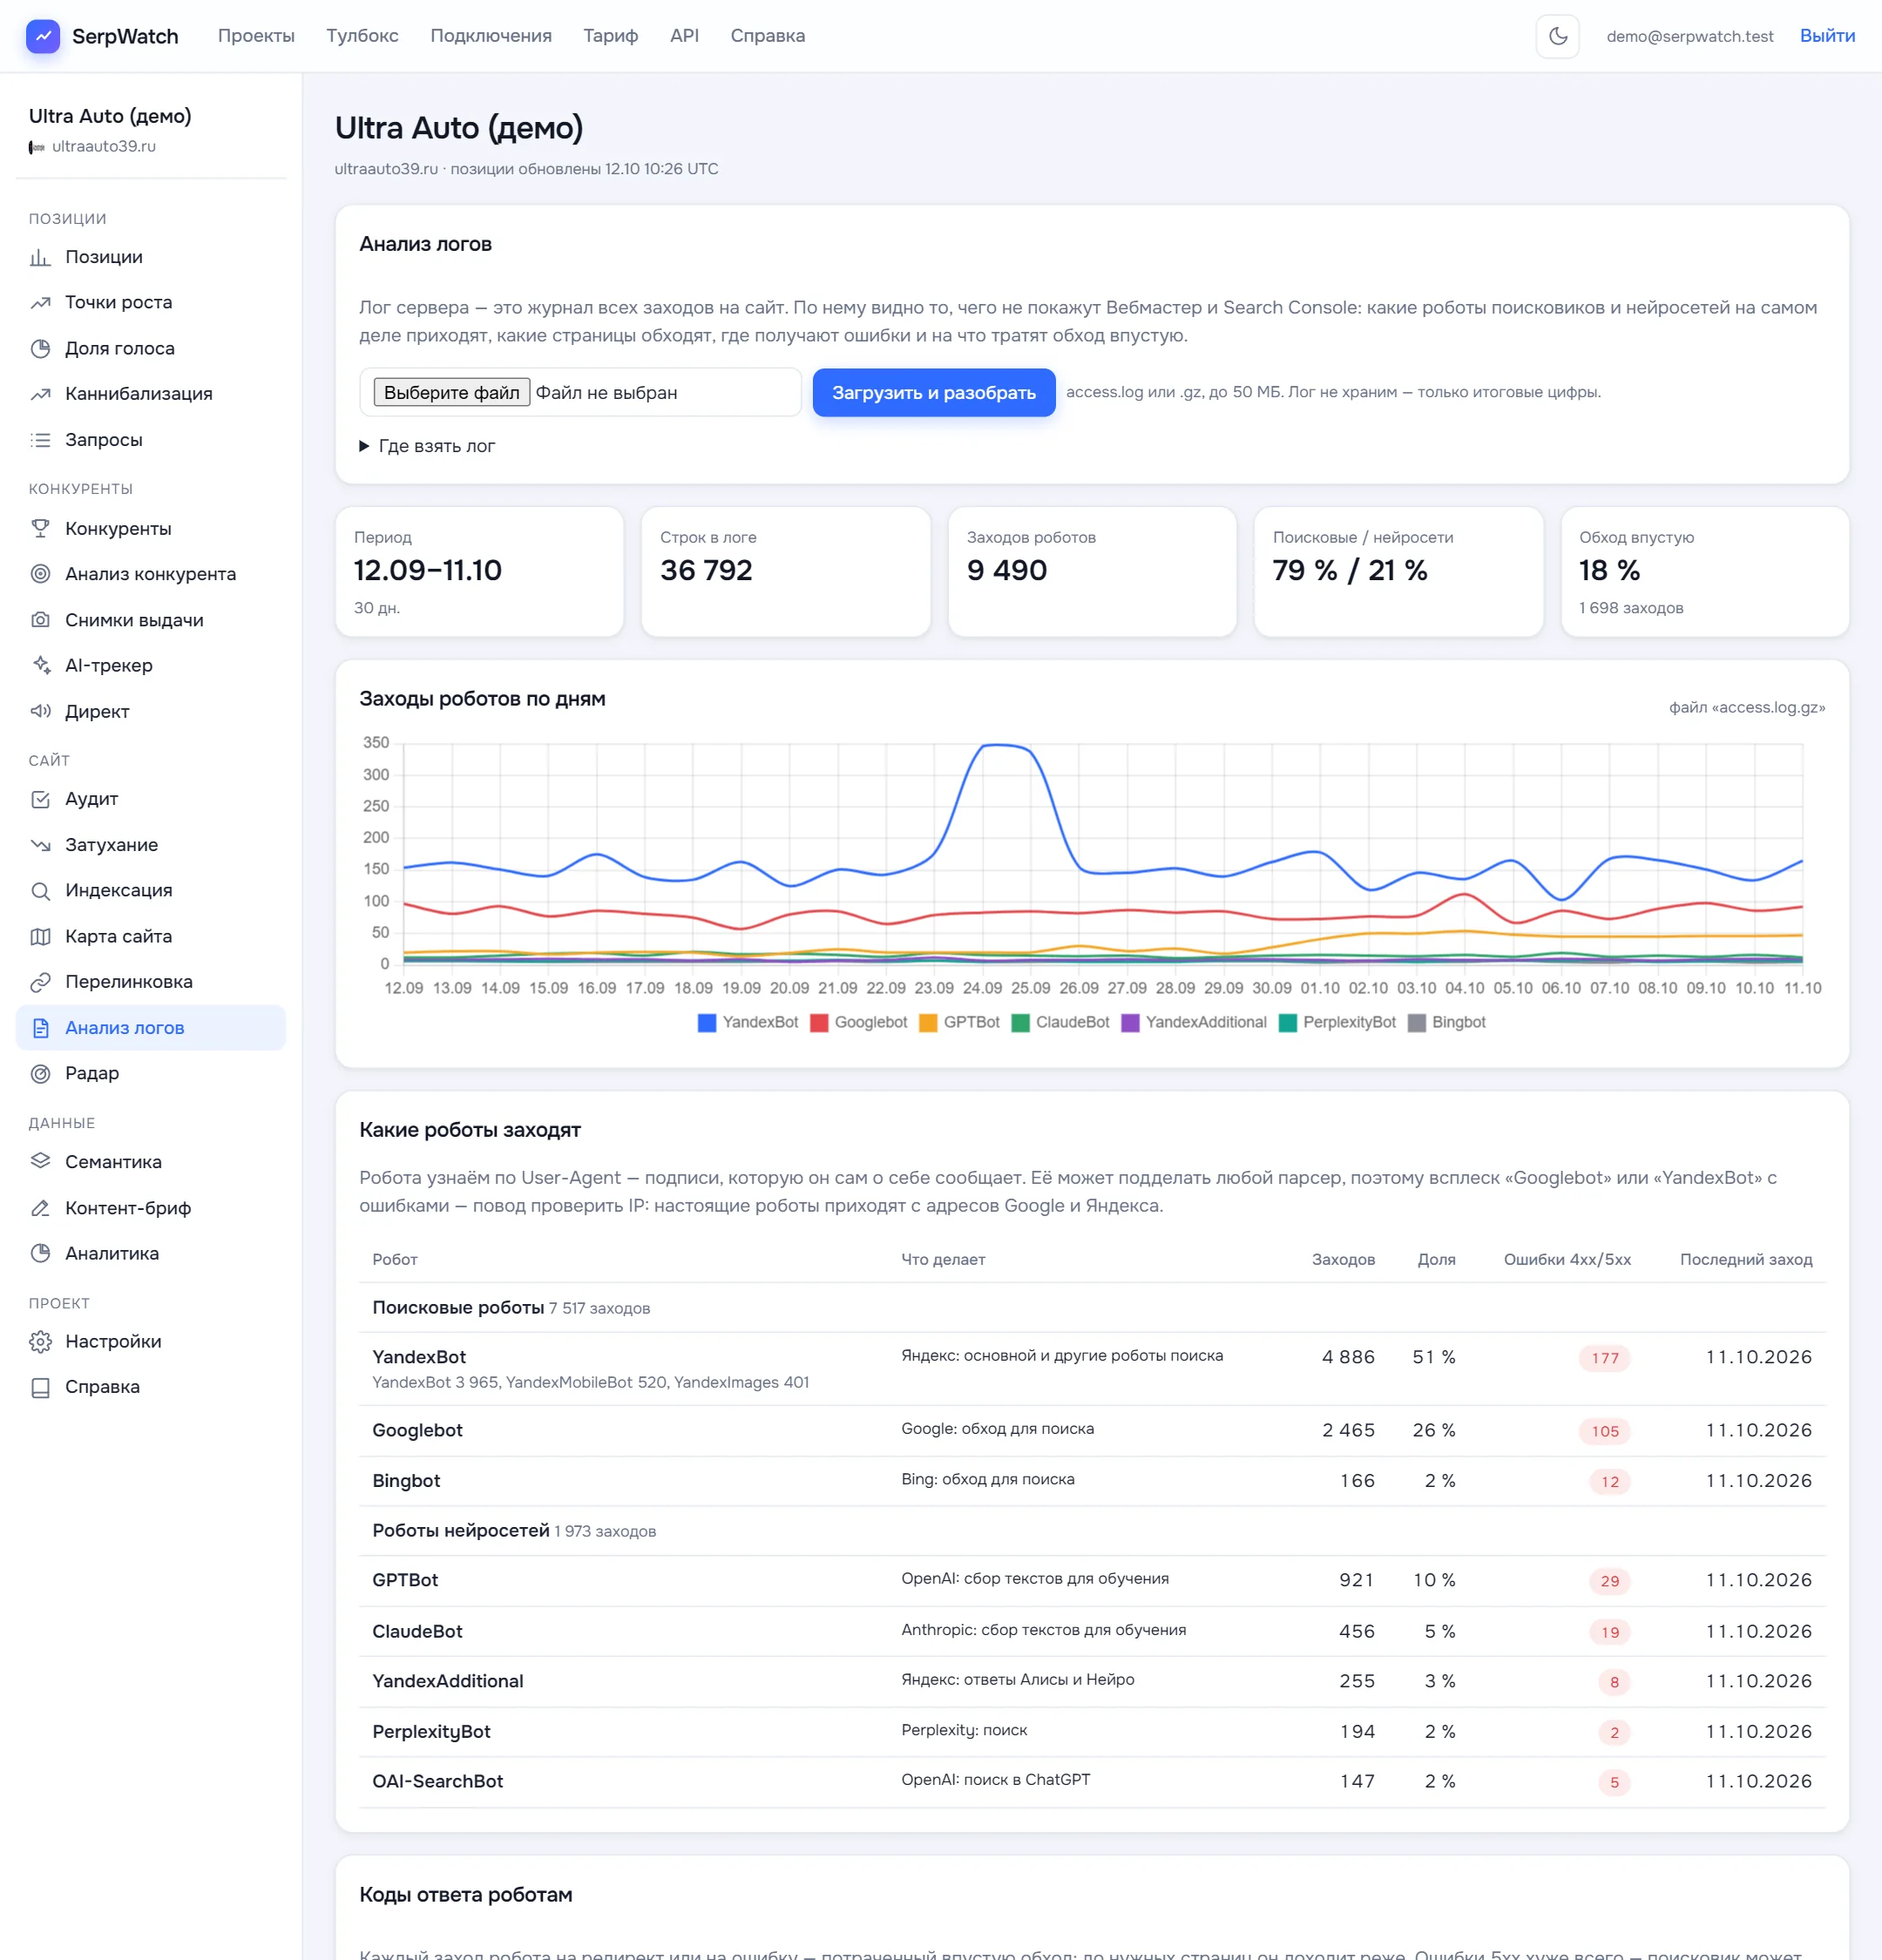
Если в проекте есть технический аудит или проверка карты сайта, отчёт найдёт страницы без единого захода поискового робота. Сам лог мы не храним: после разбора остаются только итоговые цифры, а файл удаляется.
Повторяйте разбор раз в месяц и после крупных изменений — переезда, смены структуры, запуска новых разделов. Так вы увидите, дошли ли роботы до новых страниц и не появились ли новые ошибки.
Частые вопросы
Чем лог лучше отчётов Вебмастера и Search Console?
Лог фиксирует каждый заход без выборки и задержки, показывает ответ сервера в момент обхода и видит роботов нейросетей, которых нет в панелях поисковиков. Панели полезны для данных об индексе и запросах — лучше смотреть оба источника.
За какой период брать лог?
Оптимально — 2–4 недели. За один-два дня картина случайна, а за полгода файл становится слишком большим. Для сайта с десятками тысяч страниц можно взять неделю.
Нужно ли закрывать роботов нейросетей?
Только если вы не хотите, чтобы тексты использовались для обучения моделей. Роботы, которые ищут ответы для пользователей (OAI-SearchBot, Claude-SearchBot, PerplexityBot, YandexAdditional), приводят на сайт людей из чатов, их обычно оставляют открытыми.
Аудит сайта в SerpWatch
≈45 проверок по 8 разделам, Core Web Vitals, подсказки как исправить, экспорт в Excel