Дубли — страницы с одинаковым или почти одинаковым текстом по разным адресам. Поисковик не хочет показывать одно и то же дважды, поэтому оставляет в выдаче одну копию. Не обязательно ту, которую продвигаете вы. А похожие страницы ещё и спорят друг с другом за один запрос, и обе застревают ниже, чем могли бы.
Разберём, откуда берутся дубли, чем полные дубли отличаются от почти одинаковых страниц и как найти их на всём сайте.
Откуда берутся дубли
- Копии услуг и городов. Страницы «Ремонт ходовой» и «Диагностика ходовой» с одним текстом, страницы городов, где поменяли только название.
- Технические адреса. Одна страница открывается со слешем и без, с параметрами сортировки или меток.
- Архивы и фильтры. Списки статей по годам, тегам и страницам пагинации часто почти не отличаются.
- Карточки товаров. Варианты одного товара с одинаковым описанием.
Полные дубли и почти-дубли
Полный дубль — основной текст страниц совпадает. Поисковик склеит их и выберет главную сам.
Почти-дубль — тексты отличаются на несколько слов: другое название города, цвет или цифра в цене. Для поисковика это всё равно одна и та же страница, и она конкурирует сама с собой. Подробнее о таком соперничестве — в статье про каннибализацию запросов.
Как SerpWatch находит дубли
Аудит сайта при обходе снимает «отпечаток» основного текста каждой страницы. Меню, шапка и подвал в отпечаток не входят — иначе все страницы сайта казались бы похожими. Отпечатки сравниваются между собой:
- «Одинаковый текст на разных страницах» — отпечатки совпадают;
- «Почти одинаковый текст на разных страницах» — отличаются совсем немного.
Страницы, закрытые noindex, и страницы, у которых canonical указывает на другую страницу из той же группы, не отмечаются: дубль уже оформлен правильно. Сравнение устроено так, что даже на сайте в десятки тысяч страниц оно занимает секунды.
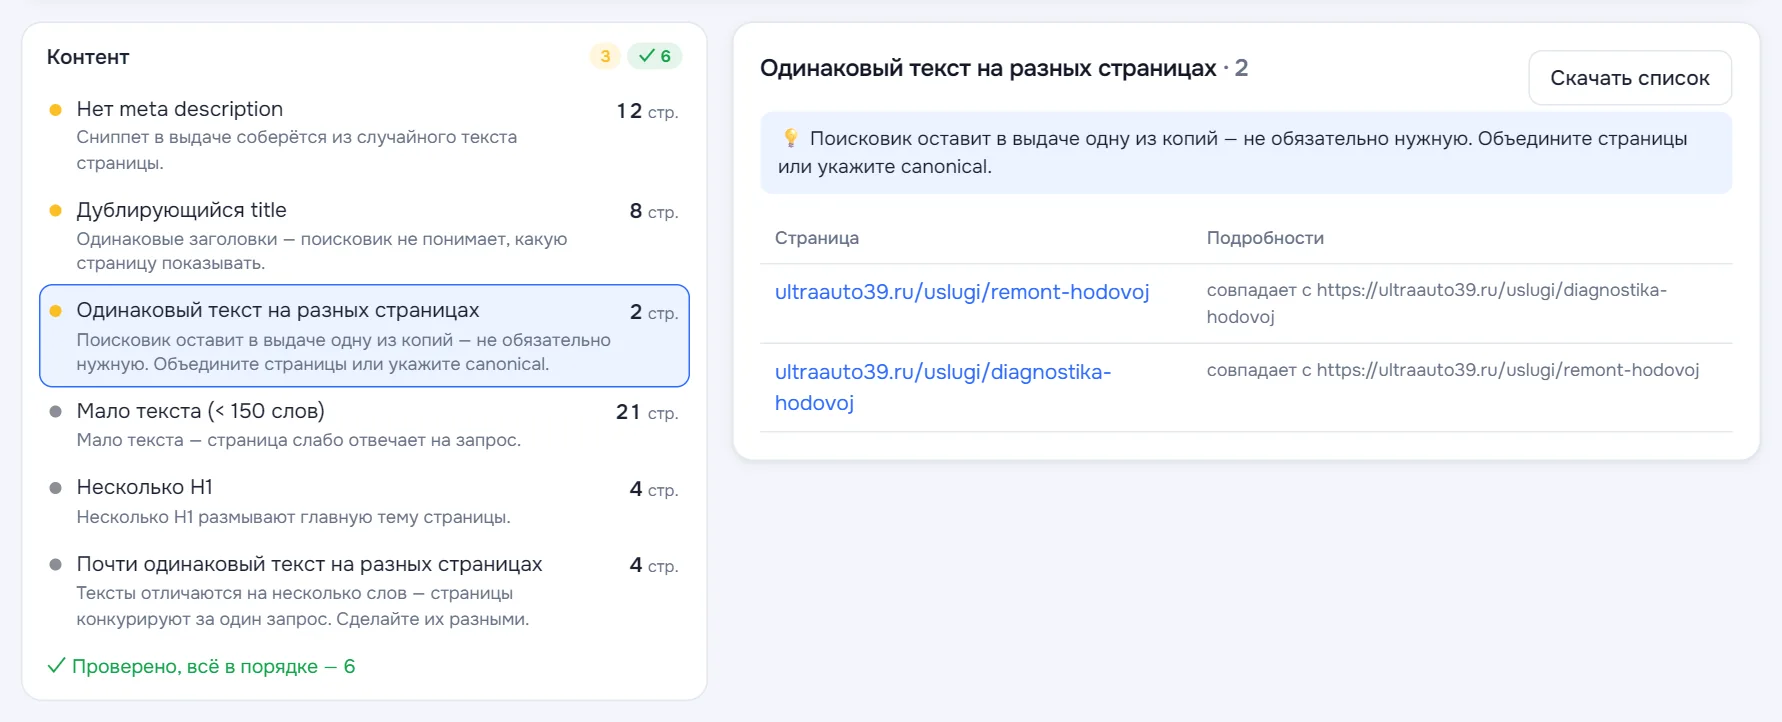
В подробностях у каждой страницы указано, с какими адресами она совпадает. Это готовый список для правки.
Как убрать дубли
- Технические дубли — склеить. Настройте 301-редирект на основной адрес или укажите canonical. Проверить, куда ведёт canonical у нескольких адресов, можно бесплатной проверкой canonical.
- Похожие услуги — разделить по смыслу. Опишите, чем отличается диагностика от ремонта: состав работ, сроки, цены, примеры.
- Страницы городов — наполнить местным содержанием: адреса, отзывы, примеры работ, особенности доставки.
- Архивы и фильтры — закрыть или сделать полезными. Ненужные в поиске страницы закройте noindex, нужные — дополните описанием.
- Перезапустите аудит и проверьте, что пункты о дублях исчезли.
Дубли заголовков и описаний аудит ищет отдельно — смотрите их в том же разделе «Контент». Полный список проверок — в статье технический аудит сайта: чек-лист.
Частые вопросы
Почему одинаковые меню и подвал не считаются дублями?
Аудит сравнивает основной текст страницы. Блоки меню, шапки, подвала и боковой колонки из сравнения исключаются, если они размечены тегами nav, header, footer и aside или основной текст лежит в main.
Короткие страницы тоже проверяются?
Страницы, где меньше 40 слов основного текста, в сравнение не попадают: на таком объёме сходство случайно. Для них есть отдельная проверка «Мало текста».
Что лучше: canonical или 301-редирект?
Если вторая страница посетителю не нужна, ставьте 301-редирект. Если она нужна людям, например вариант сортировки, оставьте её и укажите canonical на основную.
Аудит сайта в SerpWatch
≈45 проверок по 8 разделам, Core Web Vitals, подсказки как исправить, экспорт в Excel